
3 hatékony módszer a SERP-eredmények lekaparására proxykiszolgálók használatával
A Search Engine Results Pages (SERP) lekaparása a keresőmotorok eredményeiből származó adatok gyűjtését jelenti.
A Google az élen jár a keresőmotorok terén – a világpiaci részesedés 85,53%-ával. Megmutatja, hogy a Google-tól származó adatok objektíve a legértékesebbek versenytársai között.
A Google azonban nem szereti a folyamatosan adatokat gyűjtő webkaparókat. IP-címét kitilthatjuk a Google-tól, ha több kérést küld, mint egy normál felhasználó.
Ebben segíthetnek a proxy-k. Folytassa az olvasást, hogy megtudja, hogyan lehet a Google keresési eredményoldalait proxyk segítségével lekaparni.
🔑 Kulcs elvitelek
- A Google SERP kiemelt kivonatokat, kapcsolódó kereséseket, kérdéseket, termékjavaslatokat és egyebeket tartalmaz. A SERP adatok kinyerése a kiterjedt információnak köszönhetően most könnyebb.
- Python szkript használatával használhat Proxy Rotatort.
- A SmartProxy-hoz hasonló szolgáltatók SERP API-kat kínálnak, amelyek szinte korlátlan lekaparást tesznek lehetővé.
- Az adatközponti proxyk hátránya, hogy megosztott alhálózatuk ugyanabból a forrásból származik.
Mi a legjobb proxy szerver?
Smartproxy
A Smartproxy egy magas besorolású proxyszolgáltató,
amelyben sokan megbíznak. Több mint 40 millió proxyja több mint 195 helyről segít megkerülni a
CAPTCHA-kat, a földrajzi blokkokat és az IP-tiltásokat. Ingyenes próbaverziót kínál, magas,
4,7-es besorolása a Trustpiloton 89%-os 5 csillagos értékeléssel, így az egyik legjobb az
iparágban.
SERP-ek lekaparása a Google-tól proxyszerverek használatával
Amikor beír egy kulcsszót, a Google több olyan találatot ad vissza, amelyek megfelelnek a keresési lekérdezésének. Az eredmények között szerepelnek képek, videók, valamint a relevancia és hasznosság alapján rangsorolt weboldalak listája.
A Google SERP adatai az évek során változtak. Mostantól kiemelt kivonatokat, kapcsolódó kereséseket, kérdéseket, termékajánlatokat és egyebeket tartalmaz. A SERP-k lekaparása a rengeteg információnak köszönhetően könnyebbé vált, mint valaha.
A webkaparás magában foglalja a tartalom kinyerését nyilvános weboldalakról adattárolás céljából. A Google SERP-k lekaparásakor a méretezéshez proxykra van szükség a korlátozások leküzdéséhez.
Íme három módja a proxy-megoldás használatának a Google SERP-kaparásában:
1. Proxyk manuális módosítása
Összegyűjthet egy proxykészletet a kaparáshoz, és alkalmazhat egyet az eszközére. Ezt követően egyszerűen cserélje ki egy másikra néhány kérés után, vagy ha le van tiltva.
Ez a módszer azonban fárasztó, és kisméretű webkaparási projekteknél működik a legjobban. Ezt a módszert akkor használhatja, ha kutatása néhány helyalapú eredményre korlátozódik.
Eddig csak úgy juthat el, ha manuálisan lekaparja az adatokat a Google SERP-ből. A kiküldhető kérések száma korlátozott. Végül beleütközik a Google robotellenes mechanizmusaiba – a CAPTCHA végrehajtása vagy az IP-blokkoló listára való felvétel.
| ✅ Pro tipp: Unod már a CAPTCHA-kat és az IP-blokkokat? A Nexusnet teljes körű lakossági és mobil proxykat kínál, amelyek túlmutatnak az anonimitáson. Előnyök az egyének, a vállalkozások, a webadminisztrátorok és a forgalom arbitrázs szakemberei. Tudjon meg többet a 2023-as útmutatónkban a legjobb proxyszolgáltatásokról. |
A feladat félig automatizálható Python-szkriptek használatával. Ez azonban felveti az észlelés lehetőségét, mivel a kérések több „programadó” vagy botszerű.
2. Proxy Rotator használata
Ezt a technikát Python szkripttel lehet végrehajtani. Íme egy példa egy proxyforgató szkriptre, amely több Google keresési lekérdezéshez proxylistát használ:
| import kérések osztályú ProxyRotator: def __init__(self, proxy_file, user_agent): self.proxy_list = self.load_proxy_list(proxy_file) self.current_proxy = Nincs self.user_agent = user_agent def load_proxy_list(self, proxy_file): open(proxy_file, 'r') fájlként: proxyk = file.read().splitlines() visszatérő proxyk def get_next_proxy(self): ha nem self.current_proxy: self.current_proxy = self.proxy_list(0) más: aktuális_index = self.proxy_list.index(self.current_proxy) next_index = (jelenlegi_index + 1) % len(self.proxy_list) self.current_proxy = self.proxy_list(next_index) return self.current_proxy def make_request(self, url, lekérdezés): proxy = self.get_next_proxy() fejlécek = { 'User-Agent': self.user_agent } proxy = { 'http': f'http://{proxy}, 'https': f'http://{proxy}' } megpróbál: params = { 'q': lekérdezés } válasz = requests.get(url, params=params, headers=headers, proxys=proxy) response.raise_for_status() válasz visszaadása.szöveg kivéve a requests.exceptions.RequestException mint e: print(f"Hiba történt: {e}") # Példa a felhasználásra proxy_file = 'proxy_list.txt' user_agent = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, mint a Gecko) Chrome/80.0.3987.132 Safari/537.36' rotátor = ProxyRotator(proxy_fájl, felhasználói_ügynök) queries = ('Python Proxy Rotator', 'Web Scraping', 'Data Mining') url = 'https://www.google.com/search' lekérdezéshez a lekérdezésekben: válasz = rotator.make_request(url, lekérdezés) print(f”A(z) '{query}' lekérdezés eredménye:) nyomtatás (válasz) nyomtatás("------") |
Be kell gyűjtenie egy proxykészletet egy proxyszolgáltatótól vagy ingyenes forrásokból. Másolja ki és illessze be őket egy újba .txt fájlt.
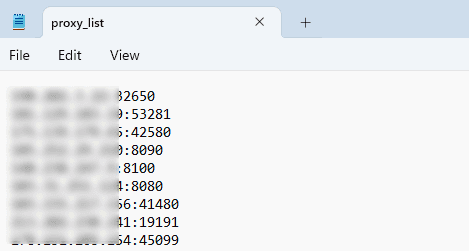
Futtassa a szkriptet a szokásos módon. Az eredményeket HTML-ben kell visszaadnia.
Ez nem a leginkább kezdőbarát lehetőség. Vannak azonban egyszerűbb módszerek is ezen a listán.
| 📓 Kapcsolódó cikk: A statikus proxyk megfelelőek egyszerű feladatokhoz, de az esetleges IP-blokkok miatt nem vágják le a webkaparáshoz vagy adatelemzéshez. Adja meg a forgó proxykat – ezek egy IP-címkészletet használnak, lehetővé téve számtalan kérés küldését különböző IP-címekkel. Útmutatónkból megtudhatja, hogyan implementálhatja a forgó proxykat a Pythonban. |
3. SERP API-k alkalmazása
Ez a legköltséghatékonyabb módszer a Google SERP-ek lekaparására.
Sok proxyszolgáltató, mint pl SmartProxyolyan SERP API-kat kínálnak, amelyek szinte korlátozások nélkül teszik lehetővé a kaparást.
| 💡 Tudtad? A Smartproxy globális szerverhálózattal büszkélkedhet, több mint 40 millió IP-vel, lehetővé téve a pontos földrajzi célzást egészen a városok szintjéig. A SmartProxy egy felhasználóbarát irányítópult és informatív tudásbázis; kezdőknek és profiknak egyaránt megfelel. A haladó felhasználók kihasználhatják az API-t kiterjedt adatbányászathoz, a kezdők pedig a kész sablonok előnyeit élvezhetik. |
Az előfizetések általában a kérelmek számán alapulnak, nem a proxykon. Mivel ezek a szolgáltatók kezelik ezt, nem kell a proxyk forgatására gondolnia.
További kényelemként az eredményeket egy szervezett JSON-fájlban kapja meg.
Kövesse az alábbi lépéseket a SmartProxy SERP API használatának megkezdéséhez:
1. Nyissa meg a SmartProxy webhelyét, és regisztráljon egy fiókot.
2. A SERP API árképzési szakaszában válasszon egy tervet a kaparási igényei alapján.
3. Nyissa meg a SmartProxy-t API játszótér hogy elkezdjen kaparni.
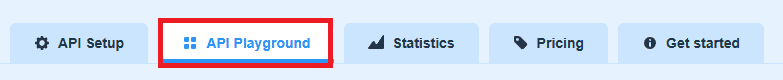
4. Állítsa be a keresési paramétereket, majd kattintson a gombra Kérelem küldése.
5. Másolja vagy töltse le az eredményeket JSON formátumban.
Beállíthat speciális keresési paramétereket, és végrehajthatja a folyamatot Python kódon keresztül.
Ezek végrehajtására vonatkozó részletes utasítások a SmartProxy súgójában találhatók.
Proxy típusok SERP kaparáshoz
A különböző proxytípusok átfedik egymást. Ismernie kell a különbségeiket annak meghatározásához, hogy melyik proxytípus a legjobb a SERP-kaparáshoz.
Íme a fő típusok:
1. Adatközponti proxyk
Ezek a proxy-k adatközpontokban vannak elhelyezve. Általában ezek a leggyorsabb proxyk az adatközpontok fejlett infrastruktúrájának köszönhetően. Az adatközponti proxy is a legolcsóbb és legkönnyebben beszerezhető.
| 🎉 Érdekes tény: A webkaparáshoz általánosan használt proxyknak két elsődleges kategóriája van. Adatközponti proxyk, népszerű választás a webkaparáshoz, valamint lakossági proxyk, amelyek internetszolgáltatókhoz vagy felhasználókhoz vannak kötve. |
Az adatközponti proxyknak az egyetlen hátránya, hogy általában ugyanaz az alhálózatuk van, mert ugyanabból a forrásból származnak. Emiatt az adatközponti proxykról érkező forgalom könnyen megkülönböztethető a hagyományos otthoni felhasználóktól.
2. Lakossági Proxyk
A lakóhelyiség a legjobb a webkaparó eszközökhöz. A hálózati forgalom rendszeres otthoni internethasználatnak fog kinézni, és különböző helyekről szerezhető be.
| 👍 Hasznos cikk: A lakossági proxy-k mások helyi IP-címeit használják az internetszolgáltatókon keresztül, és felhasználói szerződéseken keresztül valós eszközökhöz kapcsolódnak. Ezzel szemben a Datacenter proxy-kból hiányoznak a külső szolgáltatóktól származó fizikai kapcsolatok, hogy megfeleljenek a webkaparási igényeknek. Tekintse meg 7 legjobb lakossági proxyunkat, hogy segítsen kiválasztani az igényeinek megfelelőt |
Ne feledje azonban, hogy a lakossági proxykat nehezebb beszerezni és drágábbak.
3. Megosztott proxyk
Ez a proxytípus több felhasználót jelent egyetlen IP-címen. A megosztott proxyk adatközpontokból vagy lakossági IP-címekről is származhatnak. Lehetővé teszi az IP-készletek megosztását a proxy rotációjához.
4. Privát meghatalmazottak
A privát proxy-k korlátozott és személyre szabott hozzáférést kínálnak, és egyetlen felhasználó számára vannak fenntartva, biztosítva a prémium exkluzivitást minimális blokkolással. Származhatnak adatközpontokból vagy lakossági IP-címekről, testre szabott megoldásokat kínálva.
A proxyszerverek SERP-kaparáshoz való használatának előnyei és hátrányai
A proxyszerverek előnyösek lehetnek a SERP-ek kaparásakor. A folyamat során azonban hátrányaik is vannak.
Annak érdekében, hogy áttekintést adjunk arról, hogy a proxy-k használata mit jelent a SERP-kaparáshoz, íme néhány előnye és hátránya:
| Profik | Hátrányok |
| Megőrzi az anonimitást kaparás közben | Megterhelheti a túl nagy forgalommal rendelkező keresőmotorokat a féktelen kaparás miatt |
| Elkerüli az IP blokkolását vagy a robotellenes mechanizmusok általi lelassítását | |
| Gyorsabb és skálázható eredmények |
Bár a proxy-k SERP-kaparáshoz való használatának minden előnye megvan, az is fontos, hogy tiszteletben tartsa a céloldalakat.
Ennek legjobb módja, ha korlátozzuk a kérések számát, és csak nem csúcsidőben dolgozunk.
A SERP-kaparás jogszerűsége
Az adatok SERP-ből való lekaparása teljes jogi mivel az összegyűjtött adatok nyilvánosak és nem jelszóval védettek.
Az adatok keresőmotorokból való lekaparása azonban sérti a fogadó webhely szolgáltatási feltételeit. A Google maga is kaparási módszereket használ az interneten található tartalom indexeléséhez.
Olyan törvényekkel kapcsolatban, mint a Számítógépes csalásról és visszaélésről szóló törvény (CFAA) és a Digital Millennium Copyright Act (DMCA) szerint a SERP-től származó adatok tények – amelyek nem védhetők szerzői joggal.
Ezenkívül az adatkeresési eredményoldalak nyilvánosak, így a CAFA nem vonatkozik rá.
Ez azonban nem jelenti azt, hogy a Google tárt karokkal fogadja a SERP-kaparókat, vagy hogy a kaparók visszaéljenek a keresőmotorokkal.
| 👍 Hasznos cikkek: Fedezze fel a webkaparásról szóló cikkeinket, hogy értékes betekintést nyerjen. Fedezze fel azokat a technikákat, eszközöket és etikai szempontokat, amelyek segítségével hatékonyan gyűjthet adatokat a webhelyekről kutatás, elemzés vagy automatizálás céljából.  Internet Bot
JSON adatok Pythonban |
Tekerje fel
A proxyszerverek használata a SERP-kaparáshoz hatékony megoldás. Megőrzi névtelenségét, miközben lehetővé teszi a webkaparási projektek bővítését.
Ugyanakkor az is fontos, hogy ne éljünk vissza ezekkel a képességekkel a céloldalak és a rendszeres felhasználók tekintetében.
GYIK
-
A proxy jobb, mint a VPN a kaparáshoz?
Igen. A proxyk olcsóbbak, így hatalmas IP-készletek gyűjthetők össze. Ezenkívül a VPN-ek nem váltják olyan rendszeresen az IP-címeket, mint a proxyk. A proxy forgatása kulcsfontosságú a webkaparáshoz.
-
Melyik böngésző a legjobb a kaparáshoz?
Attól függően, hogy milyen módszert használ. A Google Chrome néhány böngészőbővítményt tartalmaz a webkaparáshoz és a proxykezeléshez. Egyes webkaparó eszközök szoftveralapúak, így a böngészők nem számítanak. A SERP API-k sem válogatósak a böngészők tekintetében.
-
A SEO és a SERP ugyanaz?
Nem, de szorosan összefüggenek. A SEO olyan technikákat foglal magában, amelyek segítségével a webhelyek feljebb másznak a kulcsszavas keresési eredmények rangsorában. A SERP-k maguk az eredmények.