Annak mérése, amikor az AI-asszisztensek és a keresőmotorok nem értenek egyet
Mielőtt elkezdené, fontos, hogy figyeljen erre a figyelmeztetésre: A matematika előtt áll! Ha a matematika és az egyenletek tanulása közben úszik a fejed, vagy leülsz és megesz egy egész tortát, készülj fel (vagy ragadj meg egy tortát). De ha szereted a matematikát, ha szereted az egyenleteket, és tényleg hiszed, hogy k=N (te szadista!), ó, ez a cikk izgalmat fog okozni, miközben a hibrid keresést egy kicsit mélyebben kutatjuk.
Évekig (évtizedekig) a SEO egyetlen visszacsatolási körben élt. Optimalizáltuk, rangsoroltuk és nyomon követtük. Mindennek volt értelme, mert a Google adta nekünk az eredménytáblát. (Túlságosan leegyszerűsítem, de érted a lényeget.)
Most az AI-asszisztensek ülnek a réteg felett. Összefoglalnak, idéznek és válaszolnak a kérdésekre, mielőtt egy kattintás megtörténik. Tartalma felvehető, átfogalmazható vagy figyelmen kívül hagyható, és ezek egyike sem jelenik meg az elemzésben.
Ez nem teszi elavulttá a SEO-t. Ez azt jelenti, hogy egy újfajta láthatóság most párhuzamosan fut vele. Ez a cikk ötleteket mutat be arra vonatkozóan, hogyan mérhető ez a láthatóság kód, speciális hozzáférés vagy fejlesztő nélkül, és hogyan maradjunk a tényleges ismereteink alapján.
Miért számít ez?
A keresőmotorok továbbra is szinte az összes mérhető forgalmat irányítják. Egyedül a Google csaknem 4 milliárd keresést kezel naponta. Összehasonlításképpen, a Perplexity által közölt teljes éves lekérdezési mennyiség nagyjából 10 milliárd.
Szóval igen, ehhez képest az asszisztensek még mindig kicsik. De ők alakítják az információ értelmezésének módját. Már láthatja, amikor a ChatGPT Search vagy a Perplexity válaszol egy kérdésre, és hivatkozik a forrásaira. Ezek az idézetek megmutatják, hogy a modellek jelenleg mely tartalomblokkokban (darabokban) és tartományokban bíznak meg.
A kihívás az, hogy a marketingszakemberek nem rendelkeznek natív irányítópulttal, amely megmutatná, milyen gyakran történik ez. A Google nemrégiben hozzáadta az AI mód teljesítményadatait a Search Console-hoz. A Google dokumentációja szerint a mesterséges intelligencia mód megjelenítései, kattintásai és pozíciói mostantól beletartoznak az általános „Webes” keresési típusba.
Ez a beillesztés számít, de belekeveredett. Jelenleg nincs mód az AI mód forgalmának elkülönítésére. Az adatok megvannak, csak behajtva a nagyobb vödörbe. Nincs százalékos felosztás. Nincs trendvonal. Még nem.
Amíg ez a láthatóság javul, azt javaslom, hogy használjunk proxytesztet, hogy megértsük, hol egyeznek meg az asszisztensek és a keresés, és hol térnek el egymástól.
Két visszakereső rendszer, két megtalálási mód
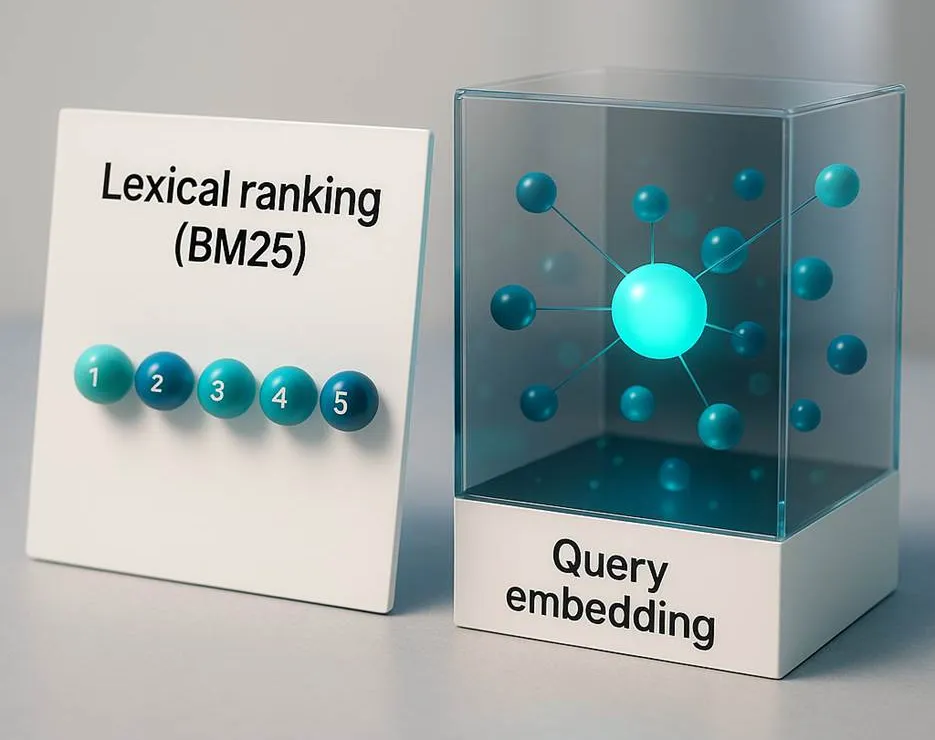
A hagyományos keresőmotorok lexikális visszakeresést használnak, ahol közvetlenül párosítják a szavakat és kifejezéseket. A domináns algoritmus, a BM25 évek óta olyan megoldásokat működtet, mint az Elasticsearch és hasonló rendszerek. A mai általános keresőmotorokban is használják.
Az AI-asszisztensek a szemantikai visszakeresésre támaszkodnak. A pontos szavak helyett leképezik a jelentést beágyazásoka szöveg matematikai ujjlenyomatai. Ez lehetővé teszi számukra, hogy fogalmilag összefüggő szövegrészeket találjanak még akkor is, ha a pontos szavak eltérnek.
Minden rendszer más-más hibát követ el. A lexikális visszakeresésből hiányzik a szinonimák. A szemantikus visszakeresés összekapcsolhatja a nem kapcsolódó ötleteket. De kombinálva jobb eredményeket produkálnak.
A legtöbb hibrid visszakereső rendszerben a két módszer egy úgynevezett szabály segítségével egyesül Reciprok rangú fúzió (RRF). Nem kell tudnia futtatni, de a fogalom megértése segít értelmezni, hogy mit fog mérni később.
RRF Egyszerű angol nyelven
A hibrid visszakeresés több rangsorolt listát egyesít egy kiegyensúlyozott listába. A fúzió mögötti matematika az RRF.
A képlet egyszerű: a pontszám egyenlő egy osztva k plusz ranggal. Ezt 1 ÷-vel írjuk (k + rang). Ha egy elem több listában is megjelenik, ezeket a pontszámokat össze kell adni.
Itt a „rang” az elem pozícióját jelenti a listában, 1-el kezdődően, mint a tetején. A „k” egy állandó, amely kisimítja a különbséget a legjobb és a középső rangsorolású elemek között. A legtöbb rendszer általában valami 60 körüli értéket használ, de mindegyik eltérően hangolhatja.
Érdemes megjegyezni, hogy a vektoros modellek nem rangsorolják az eredményeket a szóegyezések megszámlálásával. Azt méri, hogy milyen közel vannak az egyes dokumentumok beágyazás a lekérdezés többdimenziós térbe való beágyazásához. A rendszer ezután a hasonlósági pontszámokat a legmagasabbtól a legalacsonyabbig rendezi, így hatékonyan rangsorolt listát hoz létre. Úgy néz ki, mint egy keresőmotor rangsorolása, de az vezérli távolság matematikanem kifejezés gyakorisága.
Kis számokkal és két rangsorolt listával tegyük kézzelfoghatóvá. Egy a BM25-ből (kulcsszórelevancia), egy pedig egy vektormodellből (szemantikai relevancia). Az érthetőség kedvéért k = 10-et használunk.
A dokumentum a BM25-ben az 1. helyen, a vektorlistában pedig a 3. helyen
szerepel.
BM25-ből: 1 ÷ (10 + 1) = 1 ÷ 11 = 0,0909.
A vektorlistából: 1 ÷ (10 + 3) = 1 ÷ 13 =
0,0769.
Adja össze őket: 0,0909 + 0,0769 = 0,1678.
B. dokumentum a BM25-ben a 2. helyen, a vektorlistában pedig az 1. helyen
szerepel.
BM25-ből: 1 ÷ (10 + 2) = 1 ÷ 12 = 0,0833.
A vektorlistából: 1 ÷ (10 + 1) = 1 ÷ 11 =
0,0909.
Add hozzá őket: 0,0833 + 0,0909 = 0,1742.
C. dokumentum a BM25-ben a 3., a vektorlistában pedig a 2. helyen
szerepel.
BM25-ből: 1 ÷ (10 + 3) = 1 ÷ 13 = 0,0769.
A vektorlistából: 1 ÷ (10 + 2) = 1 ÷ 12 =
0,0833.
Add hozzá őket: 0,0769 + 0,0833 = 0,1602.
B. dokumentum itt nyer, mivel mindkét listán előkelő helyen áll. Ha k-t 60-ra emel, a különbségek csökkennek, és simább, kevésbé nehéz keveréket eredményeznek.
Ez a példa pusztán szemléltető jellegű. Minden platform másképp állítja be a paramétereket, és egyetlen nyilvános dokumentáció sem erősíti meg, hogy melyik motor melyik k értéket használja. Tekintsd úgy, mint analógiát arra vonatkozóan, hogyan kell több jelet együtt átlagolni.
Ahol ez a matematika valójában él
Soha nem kell saját kezűleg kódolnia, mivel az RRF már a modern keresési verem része. Íme az ilyen típusú rendszerek példái az alapszolgáltatóktól. Ha mindezt végigolvassa, mélyebben megértheti, hogy az olyan platformok, mint a Perplexity, hogyan teszik azt, amit:
Mindegyik ugyanazt az alapfolyamatot követi: visszakeresés BM25-tel, visszakeresés vektorokkal, pontozás RRF-vel, és összevonás. A fenti matematika a fogalmat magyarázza, nem pedig a szó szerinti képletet minden termékben.
Hibrid visszakeresés megfigyelése a vadonban
A marketingszakemberek nem látják ezeket a belső listákat, de megfigyelhetjük, hogyan viselkednek a rendszerek a felszínen. A trükk az, hogy összehasonlítja a Google rangsorát azzal, amit egy asszisztens idéz, majd méri az átfedést, az újdonságot és a következetességet. Ez a külső matematika egy heurisztika, a láthatóság proxyja. Ez nem ugyanaz a matematika, amelyet a platformok belsőleg számítanak ki.
1. lépés: Gyűjtsd össze az adatokat
Válasszon ki 10 olyan lekérdezést, amely fontos a vállalkozása számára.
Minden lekérdezéshez:
- Futtassa a Google Keresésben, és másolja ki a 10 legnépszerűbb organikus URL-t.
- Futtassa egy hivatkozásokat megjelenítő asszisztensben (például Perplexity vagy ChatGPT Search), és másolja ki az összes hivatkozott URL-t vagy domaint.
Most lekérdezésenként két listája van: a Google Top 10 és az Assistant Citations.
(Ne feledje, hogy nem minden asszisztens jelenít meg teljes idézeteket, és nem minden lekérdezés váltja ki őket. Egyes asszisztensek a források felsorolása nélkül is összefoglalhatnak. Ha ez megtörténik, hagyja ki a lekérdezést, mivel egyszerűen nem mérhető így.)
2. lépés: Számíts három dolgot
- kereszteződés (I): hány URL vagy domain jelenik meg mindkét listában.
- Újdonság (N): hány asszisztensi idézet nem jelenik meg a Google top
10-ében.
Ha az asszisztensnek hat idézete van és három átfedés van, N = 6 − 3 = 3. - Frekvencia (F): milyen gyakran jelennek meg az egyes domainek mind a 10 lekérdezésben.
3. lépés: Változtassa a számlálókat gyors mérőszámokká
Minden egyes lekérdezéskészlethez:
Megosztott láthatósági arány (SVR) = I ÷ 10.
Ez azt méri, hogy a Google top 10-éből mennyi
jelenik meg az asszisztens idézeteiben is.
Egyedi asszisztensi láthatósági arány (UAVR) = N ÷ az összes asszisztensi hivatkozás az adott
lekérdezéshez.
Ez azt mutatja, hogy az asszisztens mennyi új anyagot vezet be.
Ismétlési idézetek száma (RCC) = (F összege minden tartományhoz) ÷ lekérdezések száma.
Ez azt
tükrözi, hogy egy domainre milyen következetesen hivatkoznak a különböző válaszok.
Példa:
Google top 10 = 10 URL. Segéd idézetek = 6. Három átfedés.
I = 3, N = 3, F (például.com) = 4
(négy asszisztens válaszában jelenik meg).
SVR = 3 ÷ 10 = 0,30.
UAVR = 3 ÷ 6 = 0,50.
RCC =
4 ÷ 10 = 0,40.
Mostantól numerikus pillanatképet kap arról, hogy az asszisztensek milyen szorosan tükrözik a keresést vagy térnek el attól.
4. lépés: Értelmezés
Ezek a pontszámok semmiképpen sem iparági benchmarkok, egyszerűen javasolt kiindulási pontok az Ön számára. Nyugodtan állítsa be, ha szükségesnek érzi:
- A magas SVR (> 0,6) azt jelenti, hogy a tartalom mindkét rendszerhez igazodik. A lexikai és a szemantikai relevancia szinkronban van.
- A közepes SVR (0,3–0,6) magas RCC-vel azt sugallja, hogy az oldalak szemantikailag megbízhatóak, de világosabb jelölésre vagy erősebb hivatkozásra van szükségük.
- Alacsony SVR (< 0,3) magas UAVR mellett azt mutatja, hogy az asszisztensek megbíznak más forrásokban. Ez gyakran szerkezeti vagy tisztasági problémákat jelez.
- A versenytársak magas RCC-je azt jelzi, hogy a modell többször hivatkozik a tartományukra, ezért érdemes tanulmányozni a séma- vagy tartalomtervezési jelzéseket.
5. lépés: Act
Ha alacsony az SVR, javítsa a címsorokat, az áttekinthetőséget és a feltérképezést. Ha az RCC alacsony a márkánál, szabványosítsa a szerzői mezőket, a sémát és az időbélyegeket. Ha magas az UAVR, kövesse nyomon ezeket az új tartományokat, mivel ezek már szemantikai bizalmat képviselhetnek a rést illetően.
(Ez a megközelítés nem mindig működik pontosan a leírtak szerint. Egyes asszisztensek korlátozzák az idézetek számát, vagy regionálisan változtatják azokat. Az eredmények földrajzi és lekérdezési típusonként eltérőek lehetnek. Kezelje megfigyelési gyakorlatként, ne pedig merev keretként.)
Miért fontos ez a matematika?
Ez a matematika módot ad a marketingeseknek a két lekérdezési rendszer közötti egyetértés és nézeteltérés számszerűsítésére. Ez diagnosztikai matematika, nem rangsorolás. Nem árulja el, hogy az asszisztens miért választott forrást; azt mondja, hogy sikerült, és milyen következetesen.
Ez a minta a színfalak mögött működő láthatatlan hibrid logika látható széle. Gondoljon erre úgy, mintha a fa mozgását nézné az időjárást. Nem szimulálod a légkört, csak a hatásait olvasod.
Az oldalon található munka, amely segíti a hibrid visszakeresést
Amint látja, hogy az átfedés és az újdonság hogyan játszódik le, a következő lépés a szerkezet és az egyértelműség szigorítása.
- Írjon rövid, 200-300 szavas állítás- és bizonyítékblokkban.
- Használjon egyértelmű fejléceket, golyókat és stabil horgonyokat, hogy a BM25 pontos kifejezéseket találjon.
- Adjon hozzá strukturált adatokat (GYIK, HowTo, Product, TechArticle), hogy a vektorok és az asszisztensek megértsék a kontextust.
- Tartsa stabilan a gyűjtő-URL-eket, és frissítse az időbélyeget.
- Kanonikus PDF-verziók közzététele nagy megbízhatóságú témákhoz; az asszisztensek gyakran először a rögzített, ellenőrizhető formátumokat idézik.
Ezek a lépések támogatják mind a bejárókat, mind az LLM-eket, mivel megosztják a nyelvet szerkezet.
Jelentéskészítés és vezetői keretezés
A vezetők szinte annyira nem törődnek a BM25-tel vagy a beágyazásokkal, mint a láthatósággal és a bizalommal.
Az új mérőszámai (SVR, UAVR és RCC) segíthetnek lefordítani az absztraktot valami mérhetővé: meglévő SEO-jelenléte mennyit hordoz az AI felfedezésében, és hol hivatkoznak helyette a versenytársakra.
Párosítsa ezeket az eredményeket a Search Console mesterséges intelligencia mód teljesítményének összesített értékével, de ne feledje: jelenleg nem lehet elkülöníteni az AI mód adatait a szokásos webes kattintásoktól, ezért az AI-specifikus becsléseket tekintse irányadónak, nem pedig véglegesnek. Azt is érdemes megjegyezni, hogy az adatok elérhetőségének továbbra is lehetnek regionális korlátai.
Ezek a korlátok azonban nem teszik kevésbé hasznossá a matematikát. Segítenek az elvárások reálisan tartásában, miközben konkrét módot adnak arra, hogy a vezetőkkel beszélgessünk az AI-vezérelt láthatóságról.
Összegzés
A keresés és az asszisztensek közötti szakadék nem fal. Ez inkább jelkülönbség. A keresőmotorok rangsorolják az oldalakat, miután a válasz ismert. Az asszisztensek lekérik a darabokat, mielőtt a válasz létezne.
Ebben a cikkben a matematika egy ötlet arra, hogyan lehet megfigyelni ezt az átmenetet fejlesztői eszközök nélkül. Ez nem a platform matematikája; ez egy marketinges proxy, amely segít láthatóvá tenni a láthatatlant.
Végül az alapok ugyanazok maradnak. Továbbra is az átláthatóság, a szerkezet és a tekintély érdekében optimalizál.
Mostantól mérheti, hogy ez a jogosultság hogyan mozog a rangsorolási rendszerek és a visszakereső rendszerek között, és ezt reális elvárások mellett teheti meg.
Ez a láthatóság, megszámlálva és kontextusba helyezve, így marad a modern SEO a valóságban.
Ez a bejegyzés eredetileg ekkor jelent meg Duane Forrester dekódolja.