Miért az adatintegritás az új technikai SEO: a feltérképezéstől a bizalomig
Az elmúlt két évben a Google kilenc ItemType támogatását megszüntette gazdag találati galériájából. Ez nem sokkal a ChatGPT elindítása és a tömeges elfogadás kezdete után történt:
Továbbra is kérdés, hogy ez a csökkenés folytatódik-e, de a legutóbbi eltávolítás – GYIK/GYIK oldal – azóta némi vitát váltott ki a schema.org szerepéről a Keresés jövőjében.
A séma halott, igaz?
Míg egyesek teszteket és kísérleteket végeznek annak megértésére, hogy a séma valóban pozitív hatással van-e arra, hogy a platformra adott válaszokban hivatkoznak-e, Gianluca Fiorelli különösen azt figyelte meg, hogy ezeket a teszteket korlátozott adatkészleteken végezzük. Ezt szem előtt tartva, emlékeztessük magunkat a GYIK bővített találatokra vonatkozó megszüntetési üzenet szövegére:
„…2026 júniusában megszüntetjük a GYIK keresési megjelenését, a bővített eredmények jelentését és a támogatást a Rich results tesztben.”
Itt figyelje meg, mit nem említettek – vagyis, hogy a GYIK séma használata már nem kötelező. Ennek az az oka, hogy az elavulás csak a bővített eredményekre vonatkozik – ez egy megjelenítési funkció. A séma maga egy megértési réteg – azonosítja az entitásokat és a köztük lévő kapcsolatokat. A séma halott? Véleményem szerint messze van ettől. Míg egyes tulajdonságok elavulnak, mások, például a Termék, kiterjesztésre kerülnek.
Ennek ellenére tisztában vagyok azzal is, hogy a séma hozzáadása nem egy varázslat, amely hozzájárul az idézetszám növekedéséhez. Ez a növekedés azonban túlmutat azokon a mérőszámokon, amelyekre támaszkodni szoktunk, mint például az idézetek, benyomások stb. Suganthan Mohanadasan írt egy nagyszerű cikket arról, hogy a sémának három „élete” van:
- A Google indexelési folyamata.
- LLM előképzés (indirekt).
- LLM futásidejű lekérdezés.
A keresőoptimalizálók történelmileg az 1. helyre összpontosítottak, mivel ez pozitívan járulhat hozzá a sikermutatókhoz. A séma azonban túlmutat azon, amit megszoktunk, vagy amiről pontosan beszámolunk. A séma nem haldoklik; az egyik megjelenítési funkció, amelyből hasznot húzott, ehelyett csökken.
A SEO legnagyobb veszélye: kétértelműség
A séma egy ontológia, amely webes szabványként hozzájárulhat az adatok integritásához. Az adatok integritását fenyegető kockázat a kétértelműség. A kétértelműség hallucinációkhoz vezet. Hallucinációk hógolyó. Végül az eredmény összeáll, ami pontatlan eredményekhez, vagy akár helytelen LLM-előképzéshez vezethet, aminek hosszan tartó hatásai lehetnek.
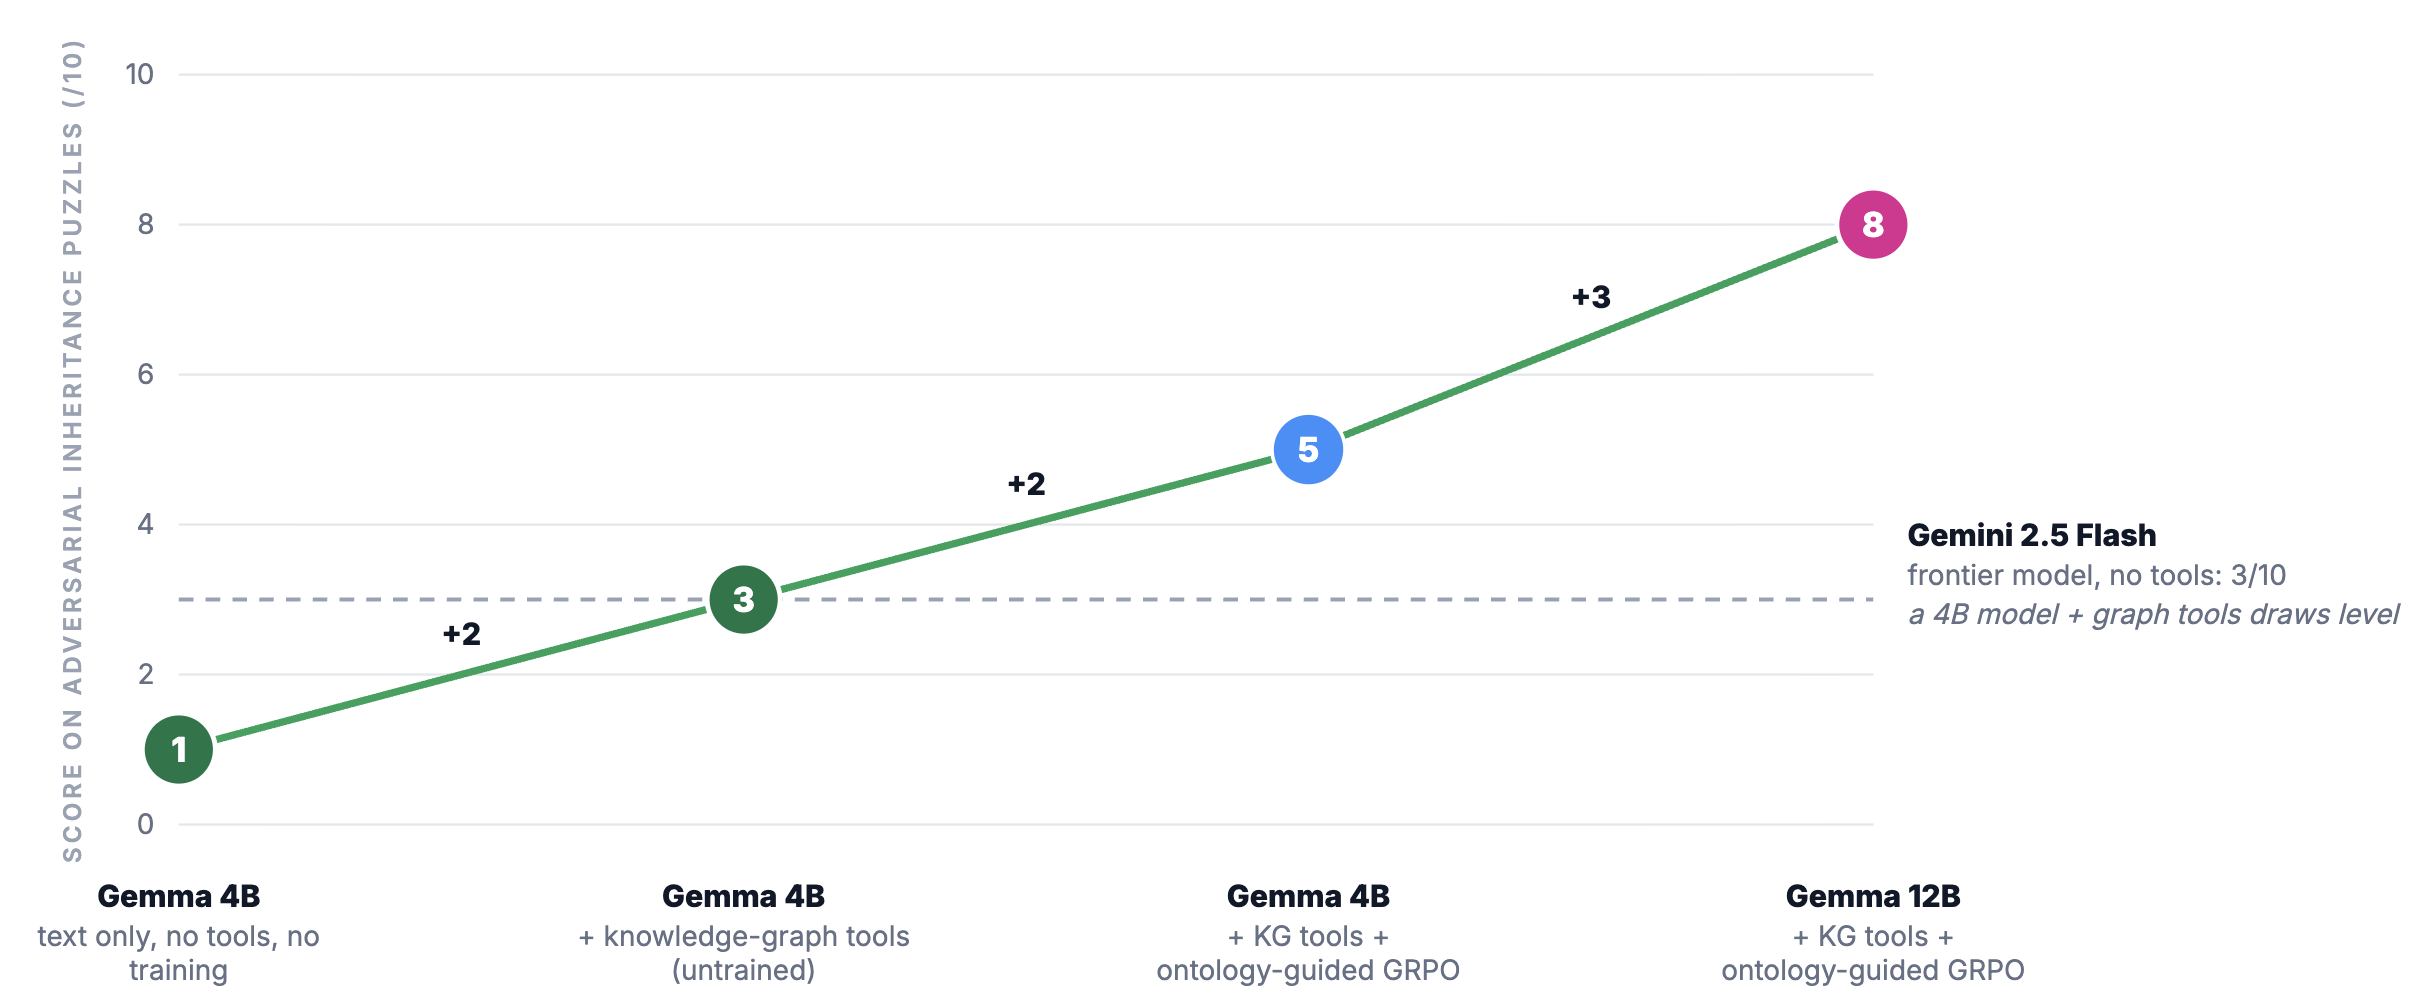
Ha egy ügynök félreolvashatja Önt, egy bizonyos ponton meg fogja tenni. Az LLM-ek ekkor azt kockáztathatják, hogy „szemantikai sodródásba” utazzanak, a tényektől elszakítva és a narratíva javára. Ezt Andrea Volpini és Chiara Carrozza „Sangue e Grafi: Teching a Small Model to Read the Bloodline” című írása tárta fel, ahol a határmodellek hajlamosak voltak a narratívára a tények helyett, míg egy kis modell, amely tudás-gráf eszközöket kapott, szintet ért velük.
→ További olvasnivalók: Információkeresés 1. rész: Egyértelműség
Az adatintegritás 5 rétege
Mindez megerősíti azt a meggyőződésemet, hogy a SEO szerepe az adatok integritásának maximalizálása, amiben a séma is szerepet játszik. Az alábbiakban öt réteget mutatok be arra vonatkozóan, hogy mit tartalmazhat az adatintegritás:
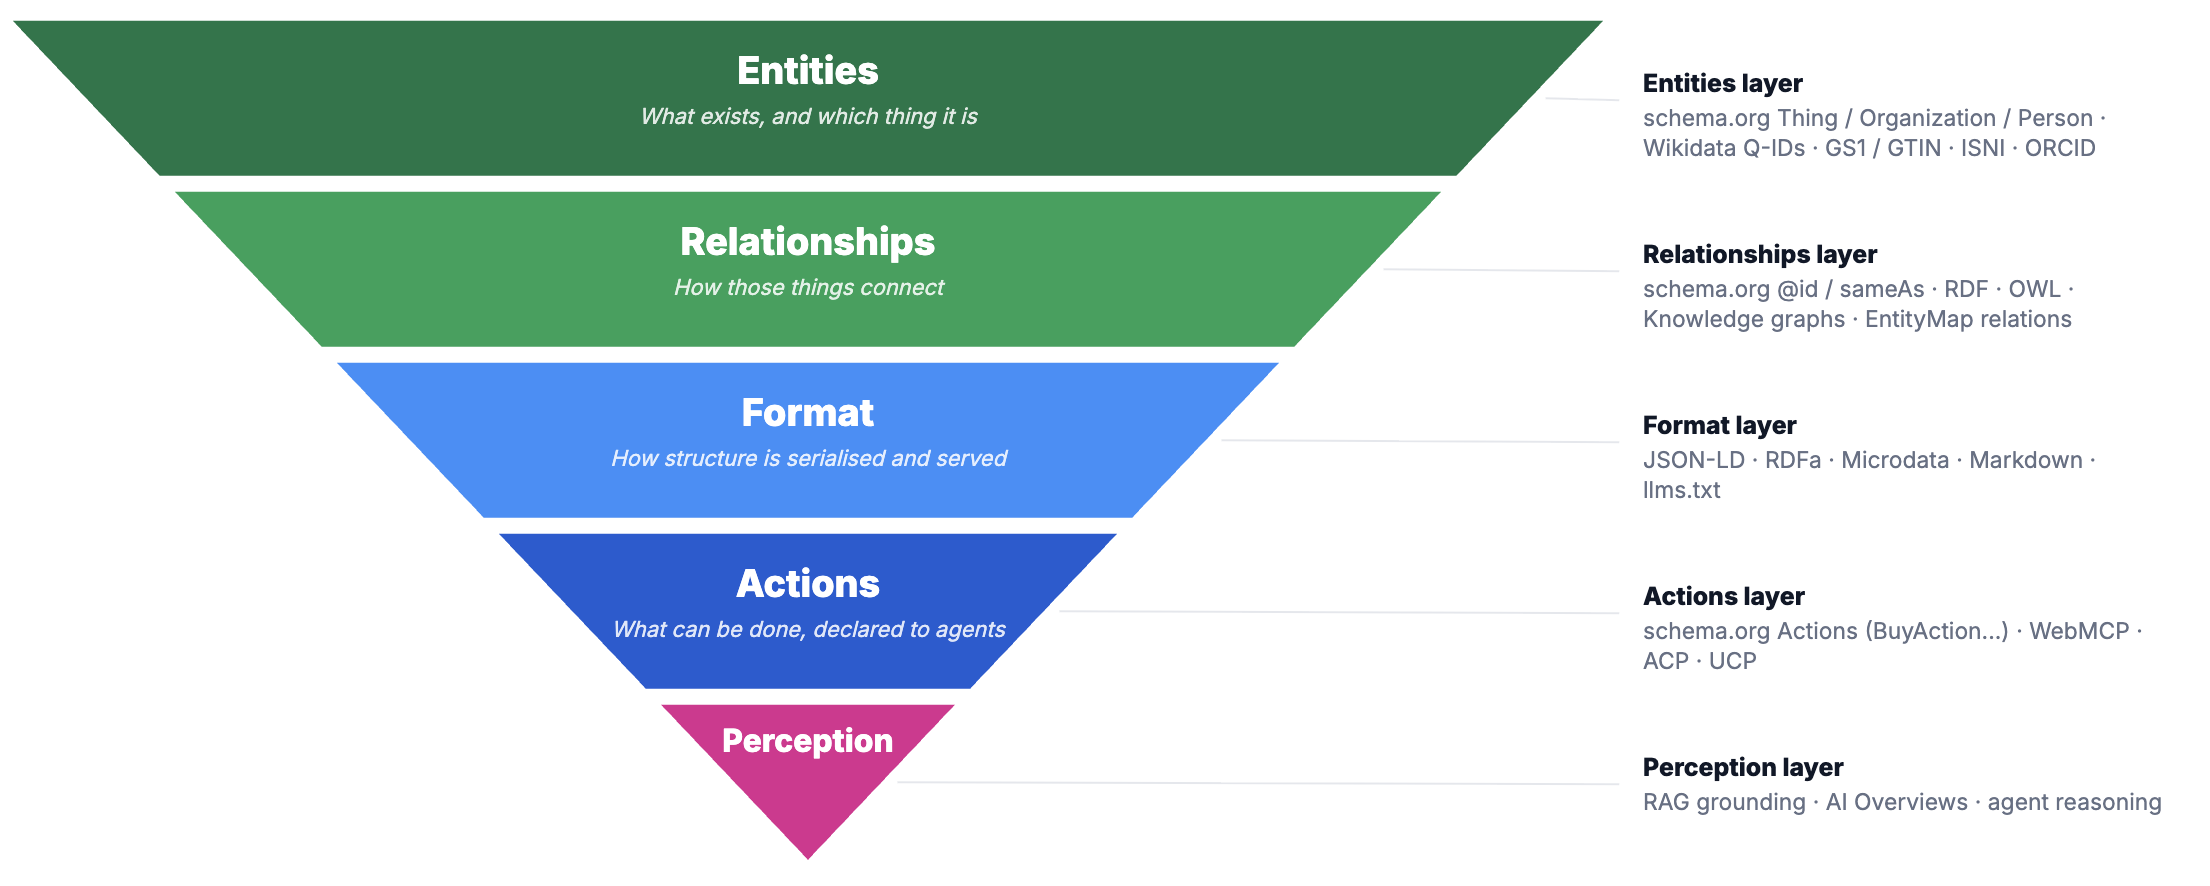
- Entitások: Mi létezik, és mi az. Dolog, szervezet és személy, @ids-vel stabilizálva, és Wikidatához, GS1-hez, ISNI-hez vagy ORCID-hez kötve, hogy az ügynök a gyümölcséből ismerje meg az Ön „almáját”.
- Kapcsolatok: Hogyan kapcsolódnak ezek a dolgok. @id és sameAs, RDF. A Yoast SEO séma-összesítő funkciója és Dixon Jones EntityMapje.
- Formátum: Hogyan történik a struktúra sorozatosítása és kiszolgálása. JSON-LD, RDFa és Microdata. Markdown is (beleértve az LLMs.txt, agents.md, OKF fájlokat) és a végpontokat (content negotiation, ARD, MCP).
- Műveletek: Mit lehet tenni, bejelentették az ügynököknek. Schema.org-műveletek, például a BuyAction, valamint az újabb WebMCP, ACP és UCP.
- Észlelés: Földelés, harmadik fél észlelése, érzése stb.
Összesítés, útmutatás és fogyasztás
Egy tavaly októberben írt bejegyzésemben azt mondtam: „A keresőoptimalizálásnak figyelembe kell vennie az internet mindkét oldalát, és azt, hogy hogyan szolgálják ki mindkettőt.” A kialakulóban lévő protokollok (melyek mindegyikét az elmúlt két évben indították el) azt mutatják, hogy ez igaz, ahol egy új „ügynöki földelő verem” általában a három cél egyikét fogadja el:
| Jegyzőkönyv | Cél | Mit csinál |
| sitemap.xml | Összevonás | Minden kanonikus URL egyetlen XML-indexbe. |
| llms.txt | Összevonás | Egy webhely tartalmának összefoglalása fontos információkkal és további olvasmányokhoz vezető linkekkel. |
| Yoast séma aggregáció | Összevonás | Oldalszintű JSON-LD egyetlen összekapcsolt webhelyszintű grafikonba. |
| EntityMap | Összevonás | Egy webhely entitásnyilatkozatai egyetlen explicit térképen. |
| Tudáskatalógus | Összevonás | Strukturált, strukturálatlan és SaaS-adatok egy szabályozott környezeti motorba. |
| OKF | Összevonás | A webhelyismeret egy leértékelési csomagba az /okf/ címen. |
| ARD · ai-catalog.json | Összevonás | Egy domain eszközei és ügynökei katalógusba; felette a nyilvántartások föderálódnak. |
| OpenKB | Összevonás | Forrásdokumentumok egy markdown wikibe összeállítva. |
| Schema.org | Útmutató | A megosztott szókincs, amely megmondja a gépeknek, hogy mit jelentenek a dolgok. |
| ügynökök.md | Útmutató | Hogyan kell az ügynököknek képviselniük és kapcsolatba lépniük Önnel. |
| Markdown ügynökök számára | Fogyasztás | Ugyanez az URL tiszta leértékelésként szolgált a tartalom egyeztetése során. |
| Markdown alternatív kimenet | Fogyasztás | Egy különálló .md verzió, amely a rel=alternate paraméterrel van összekapcsolva. |
| /feltérképezési végpont | Fogyasztás | Egy oldalt vagy a teljes webhelyet igény szerint tiszta leértékelésként jeleníti meg. |
| WebMCP | Fogyasztás | A webhely műveleteit olyan eszközökként jeleníti meg, amelyeket az ügynök hívhat. |
| NLWeb | Fogyasztás | Sémákat, hírcsatornákat és webhelytérképeket tölt be a természetes nyelvű lekérdezések megválaszolásához. |
| ACP | Fogyasztás | Ügynöki fizetés a ChatGPT-n belül a kereskedői termékadatok ellen. |
| UCP | Fogyasztás | Közös nyelv az ügynöki kereskedelmi műveletekhez a felületeken. |
Ez a három cél segít csökkenteni a kérelmek számát, miközben növeli a token hatékonyságát. A fenti protokollok némelyikével a Search Engine Journal részletesebben foglalkozott, beleértve az ACP-ről és az UCP-ről szóló sajátomat, valamint Emina Demiri-Watson alapos cikkét az OKF-ről, az ARD-ról és másokról a hónap elején.
De van valami, amivel egyik protokoll sem rendelkezik…
Nincs konszenzus vagy elfogadott szabvány
A Schema.org a Google, a Microsoft/Bing és a Yahoo! (a Yandex később csatlakozik), aki közös irányítás alatt indította el. Ugyanez történt öt évvel korábban az XML-oldaltérképpel. Amikor a keresőmotoroknak szabványra volt szükségük, egyszerűen leültek és létrehoztak egyet – együtt.
Most semmi ilyesmi nem történik, és a keresőoptimalizálók rovására megy, akik őszintén szeretnék tisztázni, hogy mit kell megvalósítani és mit nem azokon a webhelyeken, amelyeken dolgoznak. Még az alapvető fogyasztási tényeket is vitatják, ahol a leárazás körüli vita remek példa erre.
Miközben ezek a viták folytatódnak, nincs hely, ahol a platformok összegyűljenek és megállapodjanak egy univerzális szabványban. Az ökoszisztéma olyan drámaian megváltozott, hogy ezek a vállalatok nem a keresés és a web javát szolgálják, hanem most el kell tájékozódniuk arról, hogy vállalkozásaik hogyan befolyásolják a munkahelyeket, a gazdaságot, a megélhetést és az emberiség egészének jövőjét. Mint ilyen, egyszerűen nem hiszem, hogy a keresőoptimalizálók által feltett kérdések a prioritásuk tetején állnak.
Mit tehetsz most ellene?
Ha visszatekintünk az adatintegritás öt rétegére, az alábbiakban bemutatjuk azt a négyet, amelyek felett az Ön irányítása alatt áll, ha megnézi, hogyan nézhet ki egy ügynöki földelő verem:
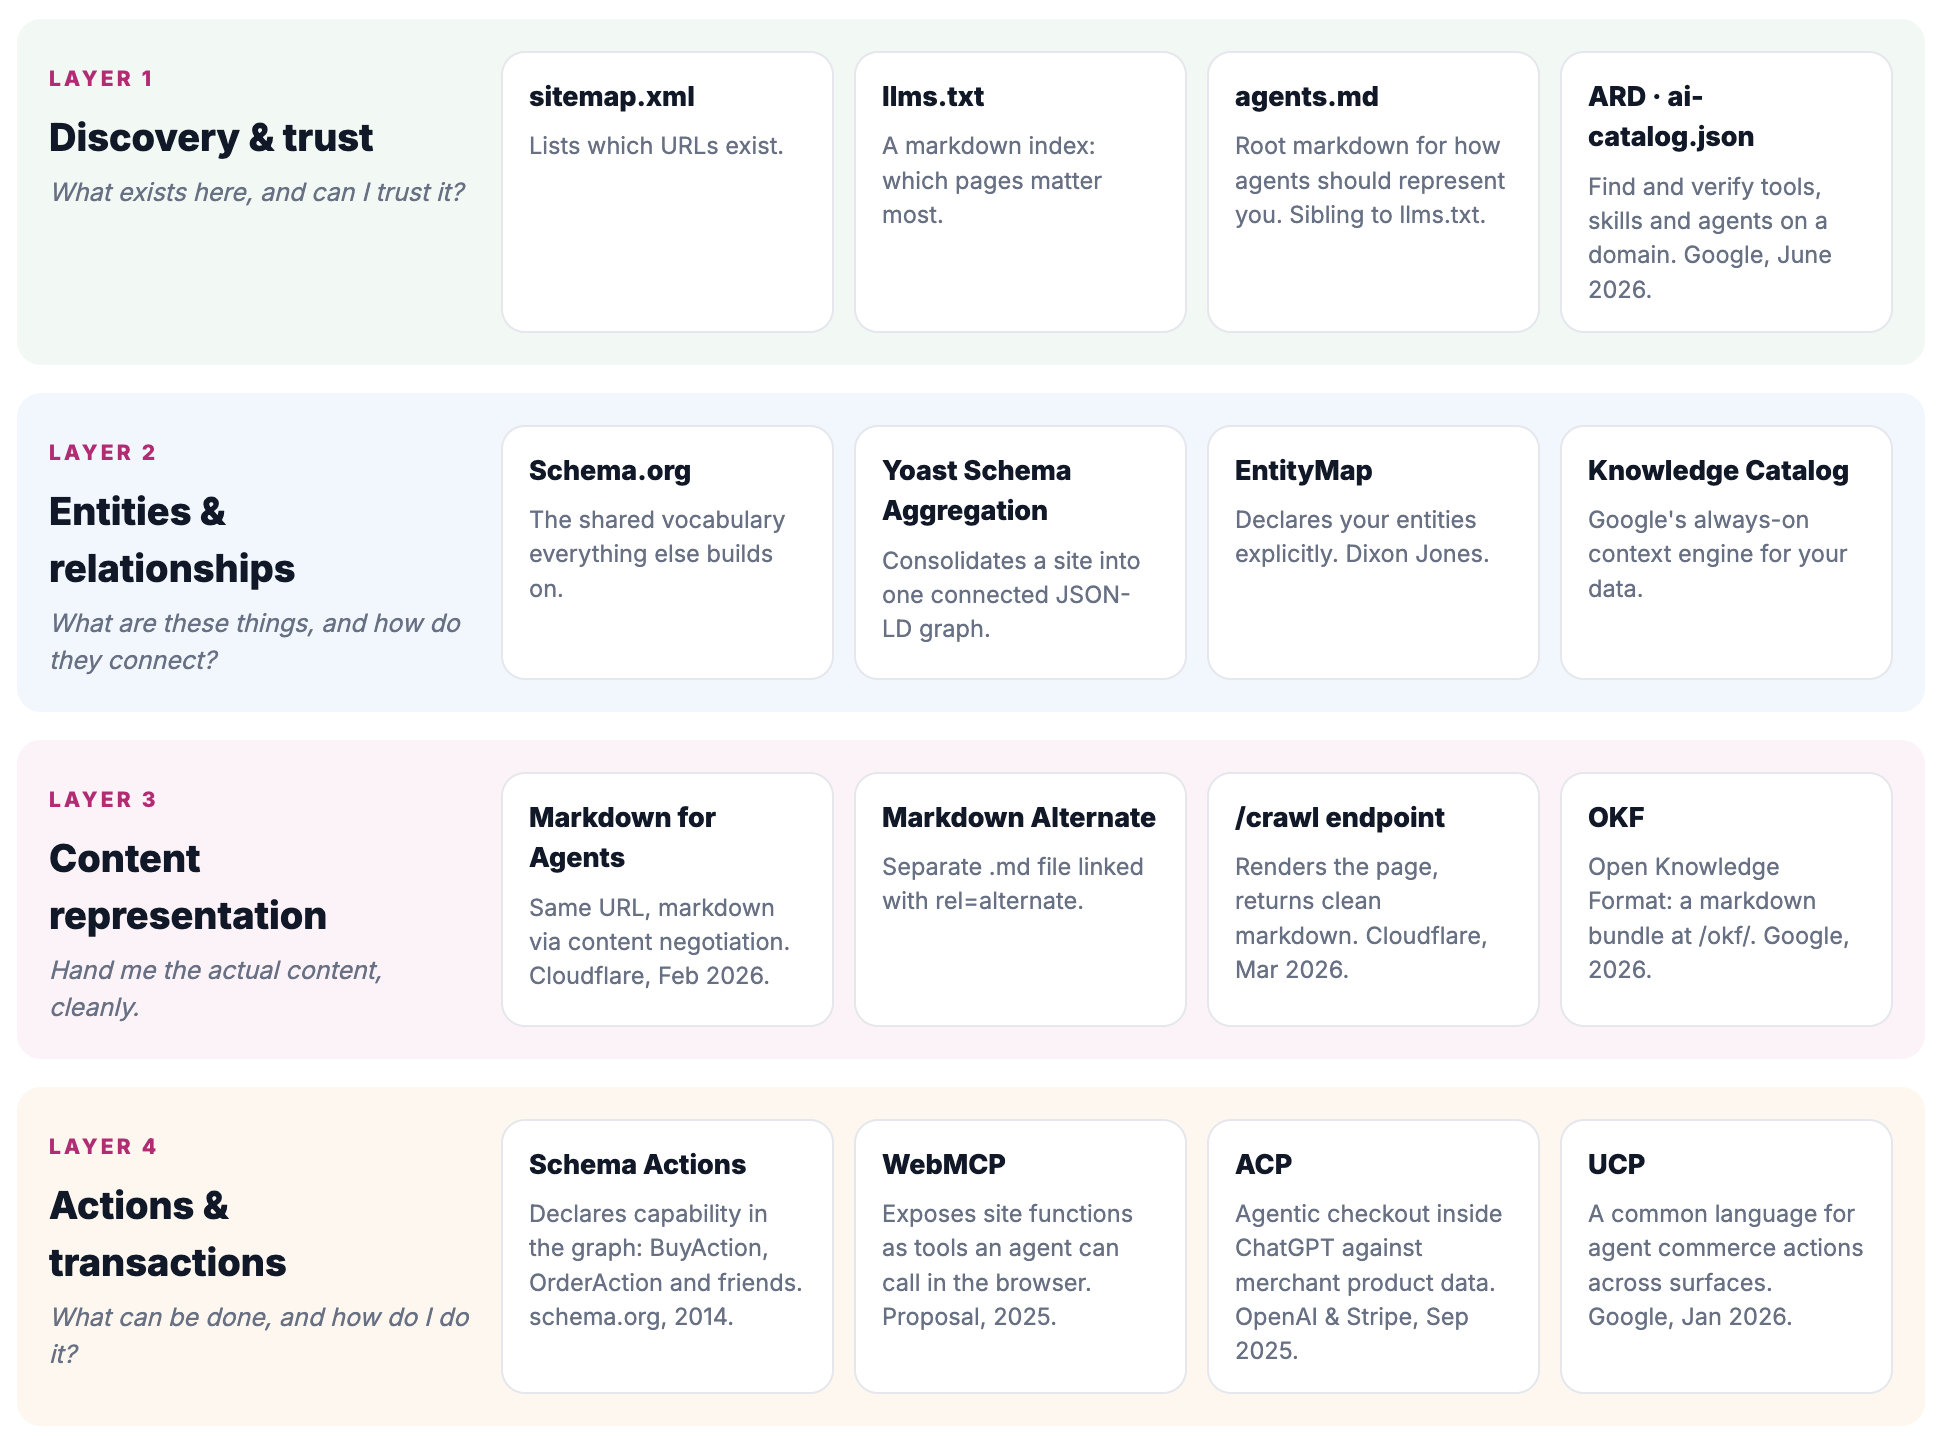
Sok mindent meg kell fontolni, és mindegyiknek más a célja és a technikai adóssága. Döntse el, hogy melyik a legmegfelelőbb az Ön számára, valamint fogadjon el bármit, ami nem igényel túl sok technikai tartozást.
Ha rendelést kellene választanom, akkor ez lenne.
- Stabilizálja @id-jét, és először adjon hozzá sameAs hivatkozásokat a Wikidatához és a többi hatósághoz, mert minden más rajta van.
- Ezután tesztelje, hogyan értelmezik valójában az NLWeb segítségével, ahelyett, hogy azt feltételeznénk, hogy a grafikon úgy olvassa, ahogyan azt tervezte.
- Ha e-kereskedelemmel foglalkozik, ellenőrizze a terméktáblázatot, mielőtt bármi fényeshez hozzányúlna, és közben nézze meg a BuyActiont: ma már csak a ReadAction és a SearchAction kerül alkalmazásra valós méretekben, így a mező valóban nyitott. Tekintse meg a legújabb híreket arról, hogy mi került hozzáadásra a terméksémához.
- Próbálja meg implementálni a WebMCP-t. Bármely webhelyen elvégezhető, és nem kell e-kereskedelemnek lennie.
- A leértékelés kiszolgálása és a tartalomegyeztetés várhat, amíg nincs tartalék mérnöki kapacitása (hacsak nem tudja használni a Cloudflare Markdown for Agents szolgáltatását).
- Nézd meg az OKF-et és az ARD-t. Amikor a Google új protokollokat indít el, mindig felfigyelek – különösen, ha arról van szó, hogy egy ügynök vagy LLM hogyan értelmezi a webhely egészét.
Ezek egyike sem egy adott protokollra tett fogadás. Ezek bármelyikének megvalósítása csökkenti annak kockázatát, hogy egy LLM-nek „hosszú utat” kell megtennie ahhoz, hogy megalkossák azt a választ, amellyel válaszolni kíván. Fogadások fedezésével bármilyen ügynököt fogadni bármilyen platformon, ez segít abban is, hogy jobban átgondolja, hogyan értelmezhetik webhelyét, és hogyan javul ez a protokollok elfogadásakor.
Még ha kisebb kísérleteket is szeretne végezni a nagyobb helyszínektől távol, nem csak azért érdemes körüljárni, hogy lássuk, vannak-e pozitív eredmények, hanem azért is, hogy megértsük, hogyan működik mindez a gyakorlatban. Pontosan ezt tettem a közelmúltban, ahol újjáépítettem a személyes webhelyemet, amelyen több „ügynökkész” protokoll fut, beleértve a tartalomegyeztetést, a markdown alternate-t, az llms.txt-t és a WebMCP-t.
Ne hajszolja a protokollt, birtokolja az alatta lévő rétegeket
Jelenleg úgy tűnik, nincs egyetlen „győztes”, aki egy javaslatból vagy protokollból webszabványsá fejlődne. Nincs olyan konzorcium, amely megismételné, amit az XML-webhelytérképpel és a sémával tettek.
A halom most már nagy, de van egy dolog, amiben mindannyian osztoznak. Akár aggregál, akár irányít, akár fogyaszt, mindegyiket ugyanaz a szubsztrát táplálja: pontos entitások, explicit kapcsolatok és tartalom, amelyet a gép találgatás vagy további kutatás nélkül tud olvasni.
A rangsorok voltak a régi web sikermutatói. Bizalom, tisztesség, pontosság és érvényesség. Ennek megszerzése továbbra is a keresőoptimalizálás feladata.